
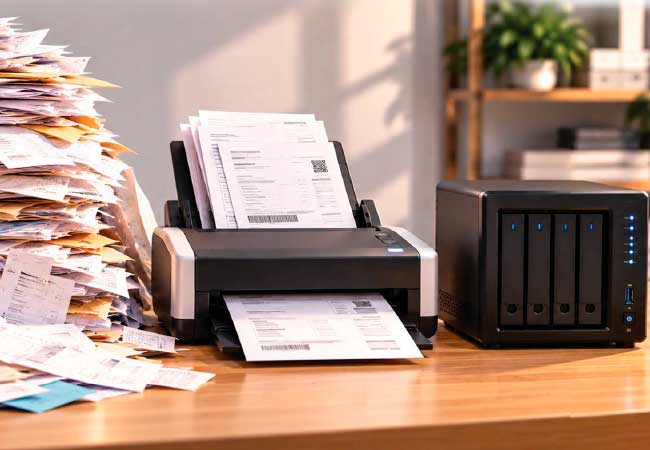
Este Informe USERS explica cómo montar un sistema de gestión documental propio con Paperless-ngx, una aplicación gratuita y de código abierto que convierte los papeles de una organización en un archivo indexado y consultable desde el navegador.
La propuesta es conservar los documentos en un servidor propio y conectarlos con el software que ya se usa.
Autor: Claudio Bottini
Un servidor propio, sin grandes exigencias
Paperless-ngx es la continuación comunitaria de dos proyectos anteriores. Su principal argumento es el autohospedaje: los documentos de una empresa suelen contener datos fiscales y de clientes, y guardarlos en una máquina propia evita depender de un proveedor externo.
La instalación recomendada usa Docker Compose (una herramienta que define varios contenedores y sus relaciones en un solo archivo). La instancia combina la aplicación web con una base PostgreSQL, un broker para la cola de tareas y dos servicios auxiliares que convierten archivos de Office a PDF.
El autor muestra el procedimiento sobre Debian, que vale igual para Windows 11 con WSL2 que para una instalación nativa o virtualizada. Un script oficial interactivo resuelve casi todo y deja la aplicación respondiendo en el puerto 8000.
Los requisitos son modestos: dos núcleos y unos 2 GB de RAM alcanzan para una oficina chica. El texto también aclara la operación diaria, con la diferencia entre detener y eliminar contenedores, y advierte que borrar los volúmenes implica perder documentos y base de datos.
Paperless-ngx transforma documentos físicos y digitales en un archivo indexado y consultable desde el navegador.
Del papel al archivo consultable
Cada documento que ingresa pasa por el OCR (reconocimiento óptico de caracteres, que extrae texto de una imagen), apoyado en OCRmyPDF y en el motor Tesseract. El sistema genera una versión PDF/A con el texto embebido y conserva siempre el original sin modificaciones.
Los archivos pueden llegar por una carpeta vigilada, por la interfaz web, por correo o por la API. Una vez indexados, quedan disponibles para búsqueda de texto completo.
La organización se apoya en etiquetas, corresponsales, tipos de documento y rutas de almacenamiento. Estas últimas definen, mediante plantillas, una estructura de carpetas que sigue siendo legible aunque algún día se abandone la aplicación.
Además de las reglas manuales de coincidencia, un algoritmo automático basado en una red neuronal propia aprende de las clasificaciones previas. Necesita muchos ejemplos y se reentrena de forma periódica.
Los campos personalizados, como el número de factura o el CUIT del proveedor, convierten el archivo en una base de datos documental cuyos valores pueden consultarse y leerse desde otros sistemas.
Las funciones de IA generativa vienen desactivadas por defecto. Pueden trabajar con un servicio remoto como OpenAI o con modelos locales mediante Ollama, y ofrecen sugerencias de metadatos y un chat basado en RAG (respuestas apoyadas en textos recuperados del propio archivo).
La elección entre ambas opciones enfrenta privacidad y costo: el servicio remoto no exige hardware, pero implica enviar el contenido a un tercero.
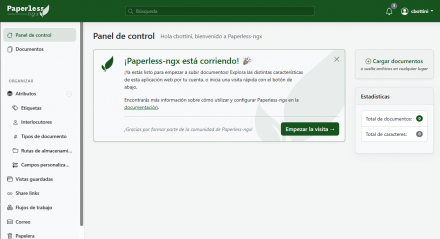
Recién instalado, el panel de control confirma que Paperless-ngx está corriendo y listo para recibir documentos. Tiene un wizard inicial estilo tutorial que recorre las opciones principales o podemos saltearlo e ir directo a lo que nos interesa usar.
Una pieza dentro de otros sistemas
El tramo más extenso del Informe USERS está dedicado a la API REST, que permite hacer por programa casi todo lo que ofrece la interfaz web. El acceso se autentica con un token generado desde el perfil del usuario.
El autor incluye scripts en PHP y en PowerShell para subir archivos en lote. Con un simple bucle es posible incorporar carpetas enteras de comprobantes, mientras el procesamiento corre en segundo plano.
La otra dirección de la integración se resuelve con flujos de trabajo que reaccionan a eventos del sistema. Su acción clave es el webhook (un aviso HTTP que Paperless-ngx envía a una URL definida por el usuario cuando ocurre un evento).
Así, una aplicación propia puede recibir la notificación de una factura nueva, consultar sus campos personalizados por la API y registrarla en su base de datos sin intervención manual. La API también admite consultas filtradas y la descarga de cada documento.
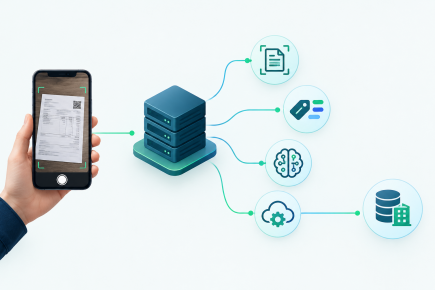
El caso que cierra el texto muestra a empleados que fotografían boletas de gastos y a un sistema de administración que recibe esos datos ya estructurados. Paperless-ngx queda así como columna documental de un desarrollo propio, que delega en él todo el trabajo de digitalización.
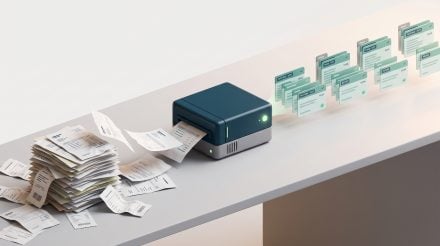
Con la API, los documentos del archivo quedan disponibles para un desarrollo propio que los lee y los consulta.
Encuentra la versión completa de la publicación en la que se basa este resumen, con todos los detalles técnicos en RedUSERS PREMIUM
También te puede interesar:
DESARROLLA TU PROPIA HERRAMIENTA PARA PDF
Manipular archivos PDF desde servicios en línea resulta práctico, pero puede exponer documentos privados a servidores ajenos. La publicación desarrolla una alternativa controlada por el usuario: una aplicación web construida con PHP y SQLite que permite unir, dividir y comprimir archivos en un alojamiento propio, sin programas externos ni bibliotecas adicionales.
Lee todo lo que quieras, donde vayas, contenidos exclusivos por una mínima cuota mensual. Solo en RedUSERS PREMIUM: SUSCRIBETE!